Splunk ile DNS Beaconing ve Tünelleme Tespiti: SPL ile C2 Avı
DNS, çoğu ağda en az denetlenen protokoldür. Neredeyse her yere açıktır, hacmi yüksektir ve güvenlik ekipleri genellikle yalnızca çözümleme hatalarına bakar. Saldırganlar için bu, görünmez bir kanal anlamına gelir: komuta-kontrol (C2) trafiğini düzenli DNS sorgularıyla taşımak (beaconing) veya veriyi alt alan adlarına kodlayarak dışarı sızdırmak (tünelleme) mümkündür. Her iki teknik de “normal” DNS trafiğinin içinde eridiğinden imza tabanlı kurallarla zor yakalanır.
Bu yazıda her iki davranışı da SPL ile tespit ediyoruz: beaconing için sorguların zamansal düzenliliğini (periyodiklik ve jitter), tünelleme için ise sorgu adının yapısal özelliklerini (uzunluk, entropi, alt alan çeşitliliği) kullanacağız. Yanlış pozitifleri azaltmayı ve tespiti risk tabanlı tespite (RBA) bağlamayı da ele alacağız.
Örnekler Splunk Enterprise 9.x üzerinde hazırlanmıştır. Entropi hesabı için Splunkbase’deki URL Toolkit (
ut_shannon,ut_parse) eklentisi varsayılmıştır; bu komutlar yoksa aynı mantık bir makro ile de kurulabilir.
Veri kaynağı ve normalleştirme
DNS görünürlüğü kaynağa göre değişir. En yaygın kaynaklar Splunk Stream, Zeek (dns.log), Windows DNS analitik/debug logları, güvenlik duvarı DNS kayıtları ve Infoblox gibi DNS çözümleyicilerdir. Kaynak ne olursa olsun, tespiti taşınabilir kılmak için CIM Network Resolution (DNS) veri modeline normalleştirmek en sağlıklısıdır; böylece sorgular query, src, record_type ve answer alanları üzerinden yazılır.
Her iki tespitte de “kayıtlı alan adı” (registered domain) kritik önemdedir; çünkü analiz tam sorgu adında değil, üst alan (parent domain) düzeyinde yapılır. URL Toolkit bunu temiz biçimde verir:
tag=dns
| ut_parse(query)
| rename ut_domain AS parent_domain
Eklenti yoksa, son iki etiketi rex ile çıkarmak çoğu durumda yeterlidir:
tag=dns
| rex field=query "(?<parent_domain>[a-z0-9-]+\.[a-z]+)$"
Beaconing tespiti: zamansal düzenlilik
Otomatik C2 trafiğinin en belirgin imzası düzenliliktir. Bir uç nokta aynı alan adına neredeyse sabit aralıklarla sorgu gönderiyorsa, bu insan davranışından çok bir zamanlayıcının işaretidir. Aralıkların standart sapması ne kadar düşükse (jitter ne kadar az ise) beacon olasılığı o kadar yüksektir.
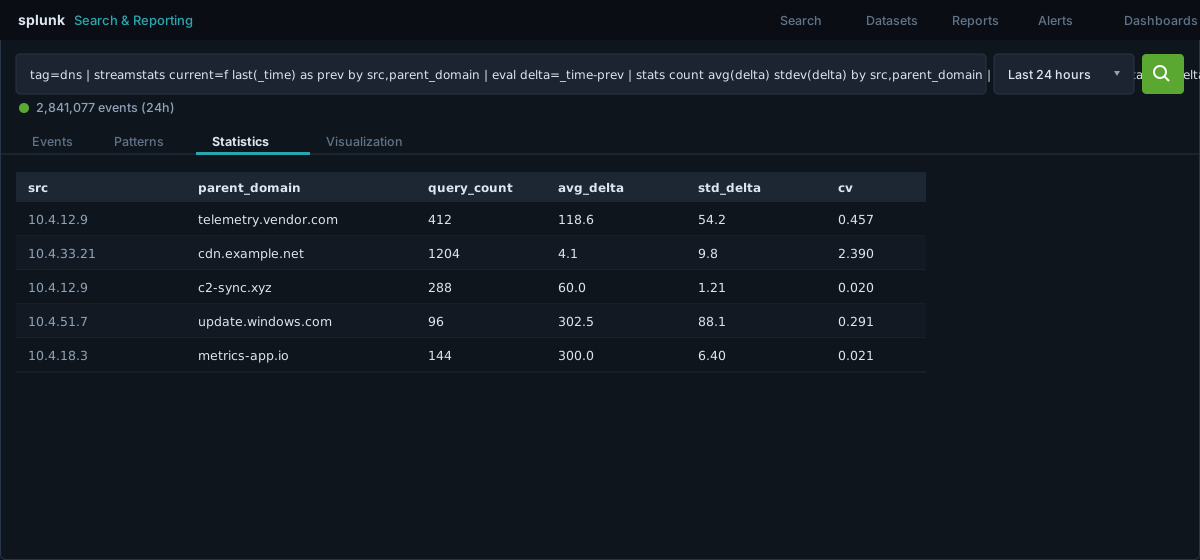
Yaklaşım şudur: her kaynak–alan çifti için ardışık sorgular arasındaki süre farkını streamstats ile hesaplıyor, sonra bu farkların ortalamasını ve standart sapmasını alıp coefficient of variation değerini (cv = std/avg) çıkarıyoruz:
tag=dns
| ut_parse(query) | rename ut_domain AS parent_domain
| sort 0 src parent_domain _time
| streamstats current=f last(_time) AS prev_time by src, parent_domain
| eval delta = _time - prev_time
| where isnotnull(delta)
| stats count AS query_count, avg(delta) AS avg_delta, stdev(delta) AS std_delta by src, parent_domain
| eval cv = round(std_delta / avg_delta, 3)
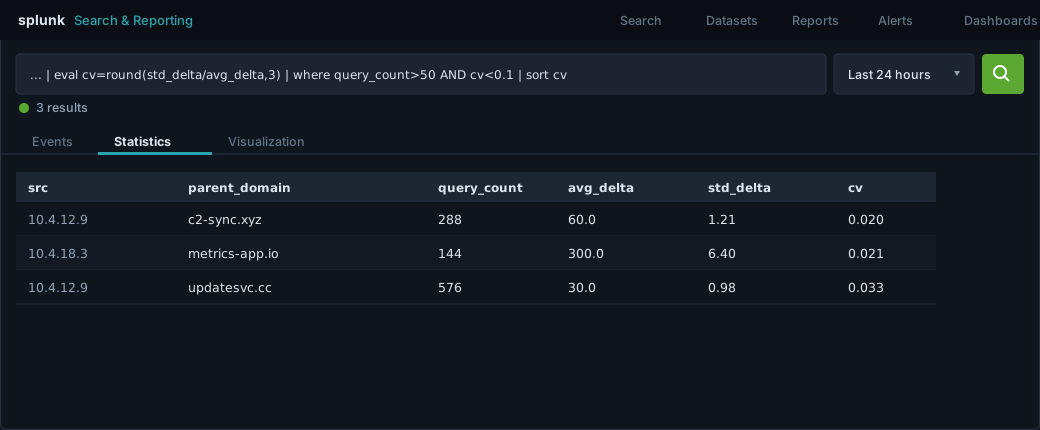
| where query_count > 50 AND cv < 0.1
| sort cv
 Düşük
cv değerleri sabit aralığa, yani jitter’sız otomatik trafiğe işaret eder.
Buradaki iki eşik belirleyicidir: query_count > 50 yeterli örneklem için, cv < 0.1 ise düzenlilik için. Değerler ortamınıza göre ayarlanır — gürültülü ağlarda cv < 0.05 daha isabetli olabilir.
Aynı iki varlığı zaman ekseninde yan yana koyduğunuzda fark gözle görülür hale gelir: normal trafik düzensiz kümeler halindeyken, beacon trafiği eşit aralıklı bir tarak gibi dizilir.
tag=dns (src="10.4.12.9" OR src="10.4.33.21")
| ut_parse(query) | rename ut_domain AS parent_domain
| eval lane = if(parent_domain="c2-sync.xyz", "beacon", "normal")
| timechart span=5m count by lane
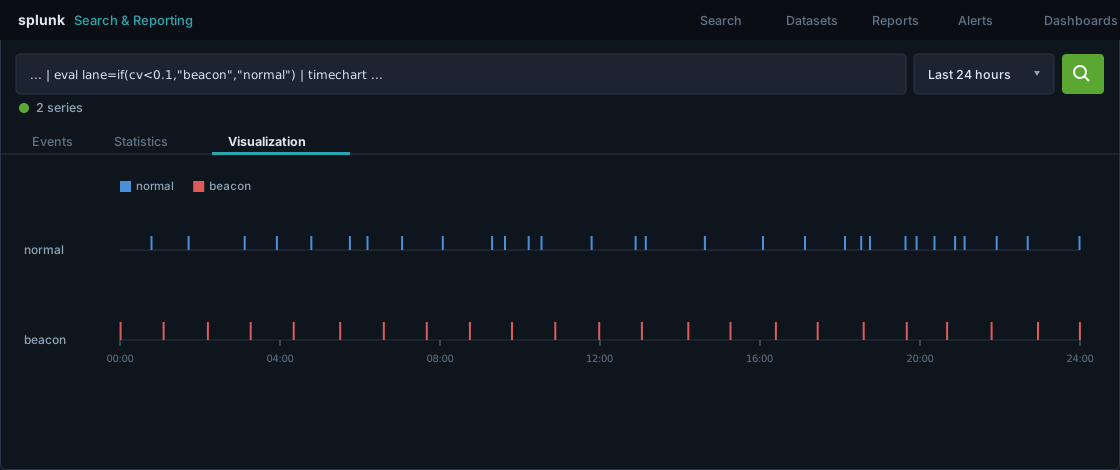 Alt satırdaki eşit aralık, bir zamanlayıcının imzasıdır; üst satır tipik kullanıcı trafiğidir.
Gelişmiş bir adım olarak, sabit aralık yerine en sık görülen aralığı arayabilirsiniz; jitter ekleyen daha olgun implantlar ortalamayı dağıtsa da, aralıkların modu (en sık tekrar eden değer) hâlâ belirgin kalır. Pratikte cv temelli yöntem, yük/maliyet dengesi açısından ilk tarama için fazlasıyla yeterlidir.
Tünelleme tespiti: sorgunun yapısı
Beaconing zamanlamaya bakar; tünelleme ise sorgunun içeriğine bakar. Veri, alt alan adlarına kodlanarak taşındığından tünel trafiği üç belirgin iz bırakır: sorgu adları olağandışı uzundur, kodlanmış veri rastgeleye yakın olduğundan entropi yüksektir ve tek bir üst alan altında çok sayıda benzersiz alt alan görülür.
Sorgu uzunluğu ve entropiyi tek geçişte çıkarabiliriz:
tag=dns
| ut_parse(query) | rename ut_domain AS parent_domain
| eval qlen = len(query)
| eval entropy = ut_shannon(query)
| stats count AS queries, dc(query) AS unique_subdomains,
        avg(qlen) AS avg_qlen, max(qlen) AS max_qlen, avg(entropy) AS avg_entropy
        by parent_domain
| where unique_subdomains > 200 AND avg_qlen > 40 AND avg_entropy > 3.8
| sort - avg_entropy
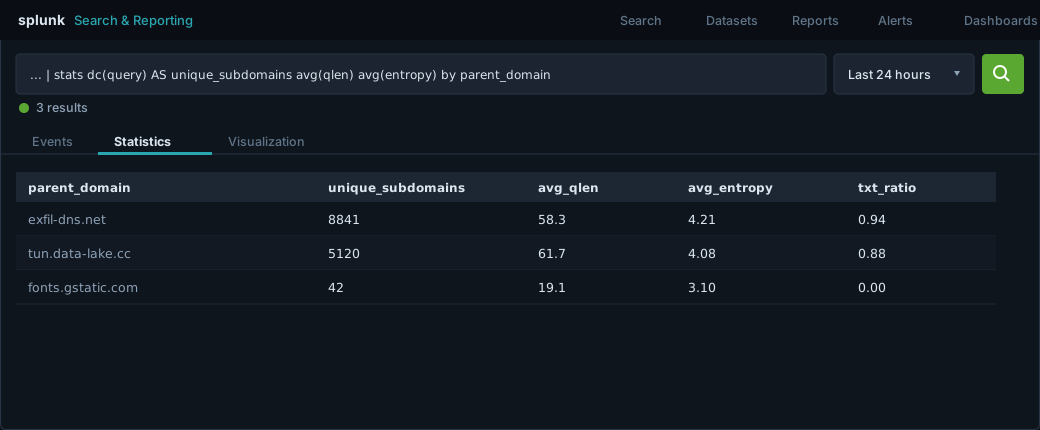 Yüksek alt alan çeşitliliği, uzun ad ve yüksek entropinin bir arada görülmesi tünellemenin tipik imzasıdır.
Burada üç sinyali birleştiriyoruz: yüksek benzersiz alt alan sayısı (dc(query)), uzun ortalama ad ve yüksek ortalama entropi. Tek başına her biri yanıltıcı olabilir; birlikte güçlü bir göstergedir.
İki boyutu — ortalama uzunluk ve entropi — bir dağılım grafiğinde çizdiğinizde, meşru alan adları sol altta toplanırken tünel adayları sağ üst köşede ayrışır:
tag=dns
| ut_parse(query) | rename ut_domain AS parent_domain
| eval qlen = len(query), entropy = ut_shannon(query)
| stats avg(qlen) AS avg_qlen, avg(entropy) AS avg_entropy by parent_domain
| table parent_domain, avg_qlen, avg_entropy
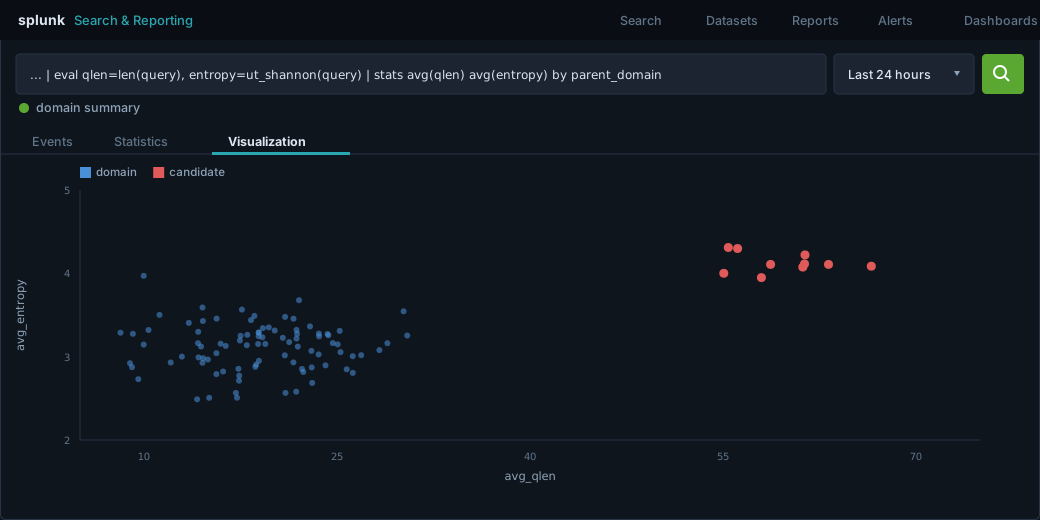 Normal trafik düşük uzunluk ve orta entropide kümelenir; tünel adayları sağ üst bölgeye düşer.
İki ek sinyal yöntemi güçlendirir. Tünelleme araçları sıklıkla TXT, NULL veya CNAME kayıtlarını tercih eder, çünkü bunlar daha fazla veri taşır:
tag=dns
| ut_parse(query) | rename ut_domain AS parent_domain
| stats count AS total,
        count(eval(record_type IN ("TXT","NULL","CNAME"))) AS high_capacity
        by parent_domain
| eval ratio = round(high_capacity / total, 2)
| where total > 100 AND ratio > 0.5
Ayrıca sızdırma sırasında rastgele üretilen alt alanların bir kısmı çözümlenemez; yüksek NXDOMAIN oranı da ipucudur:
tag=dns
| ut_parse(query) | rename ut_domain AS parent_domain
| stats count AS total, count(eval(reply_code="NXDOMAIN")) AS nx by parent_domain
| eval nx_ratio = round(nx / total, 2)
| where total > 100 AND nx_ratio > 0.3
False positive azaltma
DNS tespitinde asıl zorluk, meşru ama “tünel gibi görünen” trafiktir. CDN’ler karma (hash) içeren uzun ve yüksek entropili alt alanlar üretir; antivirüs ve güvenlik ürünleri bulut sorguları için benzer desenler kullanır; telemetri servisleri düzenli aralıklarla “beacon” atar. Bu kaynaklar ayıklanmadan üretime alınan bir kural, gürültüden kullanılamaz hale gelir.
En pratik yöntem, bilinen meşru alanları bir lookup ile dışlamaktır. Tranco/Umbrella gibi popülerlik listelerini ve kurum içi allowlist’i birleştirip sorgunun sonuna ekleyin:
...
| lookup dns_allowlist.csv parent_domain OUTPUT allow
| where isnull(allow)
Bunun ötesinde, yüksek hacimli meşru servisleri (telemetri, güncelleme, CDN) kaynak+alan bazında belirli bir süre gözlemleyip kendi ortamınıza özgü bir temel allowlist çıkarmak, kuralın isabetini en çok artıran adımdır.
Tespiti operasyonel hale getirmek
Beaconing ve tünelleme sorguları tam tarama gerektirdiğinden ham index= üzerinde pahalıdır. Büyük ortamlarda Network Resolution veri modelini hızlandırıp tstats ile çalışmak çok daha ölçeklenebilir:
| tstats summariesonly=t count FROM datamodel=Network_Resolution
  WHERE nodename=DNS BY DNS.src, DNS.query, _time span=1s
| rename DNS.* AS *
Tespit sonucunu tek başına notable olaya çevirmek yerine, ilgili kaynağın risk puanına katkı olarak yazmak daha sağlıklıdır. Böylece DNS anomalisi tek başına değil, aynı varlıktaki diğer sinyallerle birlikte değerlendirilir:
... (beacon veya tünel adayları)
| eval risk_object=src, risk_object_type="system", risk_score=70,
       risk_message="Şüpheli DNS deseni: ".parent_domain." (beaconing/tünel adayı)"
| table _time, risk_object, risk_object_type, risk_score, risk_message
| collect index=risk
Her iki tespiti saatlik zamanlanmış aramalar olarak çalıştırıp çıktılarını risk index’ine yazdığınızda, DNS katmanı artık kör nokta olmaktan çıkar ve mevcut RBA kurgunuzun bir girdisi haline gelir. MITRE ATT&CK karşılığıyla bu tespitler T1071.004 (Application Layer Protocol: DNS) ve T1048 (Exfiltration Over Alternative Protocol) tekniklerini kapsar.
DNS tespitinde mükemmel tek bir eşik yoktur; isabet, verinizi tanımak ve allowlist’i ortamınıza göre olgunlaştırmakla gelir. Kuralları bir süre düşük önem derecesiyle çalıştırıp ürettikleri adayları doğrulamak, eşikleri gerçek trafiğe göre ayarlamanın en güvenilir yoludur.
Kaynaklar
- URL Toolkit (Splunkbase) —
ut_parse,ut_shannonkomutları - MITRE ATT&CK — T1071.004 DNS ve T1048 Exfiltration Over Alternative Protocol
- Splunk Common Information Model — Network Resolution (DNS) veri modeli