Splunk MLTK (AI Toolkit) ile Anomali Tespiti: Sıfırdan Model Eğitimi
Bir korelasyon kuralının eşiğini elle belirlemek, aslında bütün varlıklar için aynı kabulü yapmak anlamına gelir. “Saatte 10 başarısız oturum açma yüksek midir?” sorusunun yanıtı, bir son kullanıcı ile bir servis hesabı için aynı değildir. Statik eşiklerin temel kısıtı budur: tek bir değeri bütün popülasyona dayatırlar. Varlık başına ayrı eşik tanımlamak ise ölçeklenmez; binlerce kullanıcılı bir ortamda bu eşiklerin bakımı pratikte mümkün değildir.
Alternatif yaklaşım, “normal”in ne olduğunu veriden öğrenmektir. Splunk Machine Learning Toolkit (MLTK; güncel sürümlerde arayüzde AI Toolkit olarak da adlandırılır), bunu SPL içinden, veriyi harici bir platforma taşımadan yapmaya olanak tanır. Bu yazıda uçtan uca bir örneği — kullanıcı bazında oturum açma hacminde anomali tespitini — gerçek sorgularla ele alıyoruz: veri hazırlığından model eğitimine, modelin operasyonel hale getirilmesine ve risk tabanlı tespite (RBA) bağlanmasına kadar.
Örnekler Splunk Enterprise 9.x ve MLTK 5.5 üzerinde hazırlanmıştır. Algoritma parametreleri sürümle değişebildiğinden, kendi ortamınızdaki geçerli parametreleri resmi dokümandan doğrulamanız önerilir.
MLTK nasıl çalışır?
MLTK, arka planda Python for Scientific Computing (PSC) eklentisi üzerinden scikit-learn algoritmalarını SPL komutlarıyla kullanılabilir hale getirir. Kurulumda PSC eklentisinin de yüklenmesi gerekir; aksi halde fit komutu algoritmayı bulamaz.
Uygulamada üç komut üzerinden ilerlenir:
fit— bir algoritmayı veriye uydurur (eğitir) veinto <isim>ile modeli saklar. Kaydedilen model bir lookup olarak tutulur;__mlspl_<isim>.csvadıylalookupsdizininde bulunur.apply— kayıtlı modeli yeni veriye uygular, yani skorlar.summary— eğitilmiş modelin içeriğini raporlar.
Anomali tespitinde birden fazla algoritma bulunur: OneClassSVM, LocalOutlierFactor, IsolationForest ve çok değişkenli senaryolar için MultivariateOutlierDetection. Bu yazıda DensityFunction kullanıyoruz. Tercih sebebi iki yönlü: by yan tümcesiyle her varlık için ayrı bir olasılık dağılımı öğrenebilmesi ve modelin diske kaydedilip apply ile tekrar tekrar kullanılabilmesidir. Örneğin LocalOutlierFactor modeli into ile kaydedilemediğinden sürekli skorlamaya uygun değildir.
Senaryo
Amaç, her kullanıcının saatlik oturum açma sayısı için bir “normal” profil çıkarmak ve ardından canlı veride bu profilin dışına taşan davranışı tespit etmektir. Ele geçirilmiş bir hesabın kısa sürede onlarca oturum açması ya da normalde günde birkaç kez görülen bir servis hesabının aniden saatte yirmiye çıkması — statik bir eşik bu durumların tamamını tek bir değerle yakalayamaz, ancak varlık başına öğrenilmiş bir dağılım bunu doğal biçimde değerlendirir.
Veri kaynağı olarak kimlik doğrulama loglarını kullanıyoruz (index=auth; Windows tarafında 4624 olayları, Linux tarafında sshd kayıtları — sourcetype kendi ortamınıza göre değişir).
1. Veriyi anlamak ve hazırlamak
Model eğitiminden önce veriyi incelemek gerekir. Modele girecek değer saatlik sayım olduğundan, bin ve stats ile zamanı kovalara bölüp kullanıcı başına sayıyoruz:
index=auth action=success earliest=-7d@d latest=@d
| bin _time span=1h
| stats count AS login_count by _time, user
Alanı modele vermeden önce dağılımını kontrol etmek yerinde olur — login_count sağa çarpık mı, kaç benzersiz kullanıcı var, boş değer dönüyor mu:
index=auth action=success earliest=-7d@d latest=@d
| bin _time span=1h
| stats count AS login_count by _time, user
| fieldsummary
Burada beklenen durum, login_count değerlerinin makul bir aralıkta olması ve çok sayıda kullanıcı için yeterli satırın bulunmasıdır. Önemli bir eşik vardır: DensityFunction‘ın her grup için güvenilir bir dağılım kurabilmesi için grup başına yaklaşık 50 veri noktası önerilir. Haftalık pencere kullanıcı başına 24×7 = 168 saatlik kova üretir; düzenli görülen kullanıcılar için bu yeterlidir. Çok seyrek görülen varlıkların modellenmesi güvenilir olmayacağından, bunları ya ayrı ele almak ya da zaman penceresini genişletmek gerekir.
2. Baz çizgiyi öğrenmek: fit DensityFunction
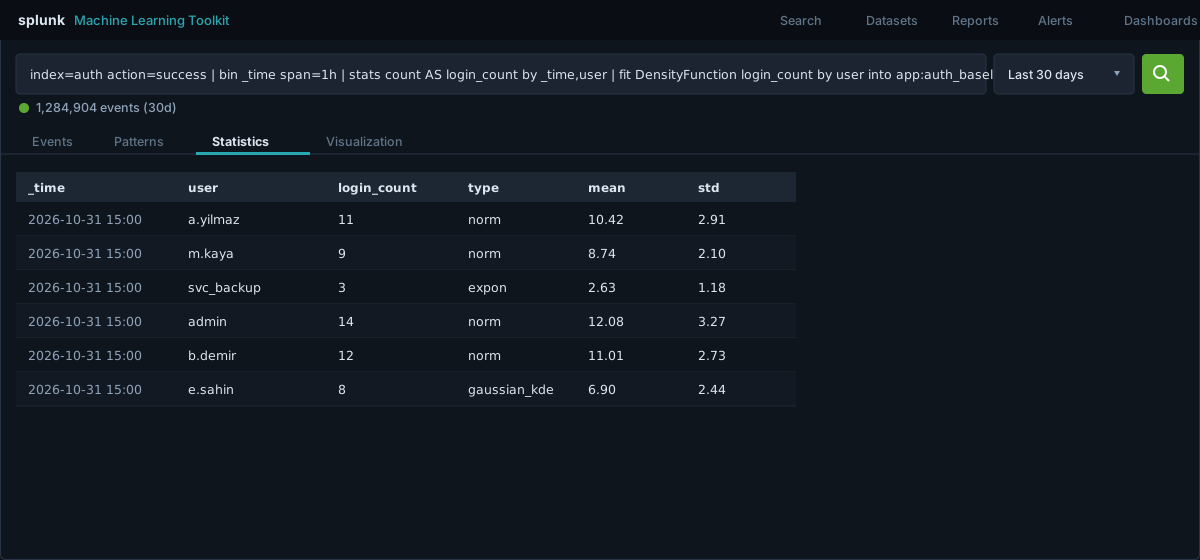
Sürecin merkezi tek bir komuttur. Son 30 günü “normal” kabul ederek kullanıcı başına dağılımı öğreniyor ve modeli app:auth_baseline olarak kaydediyoruz:
index=auth action=success earliest=-30d@d latest=@d
| bin _time span=1h
| stats count AS login_count by _time, user
| fit DensityFunction login_count by user into app:auth_baseline
    dist=auto threshold=0.01 show_density=true
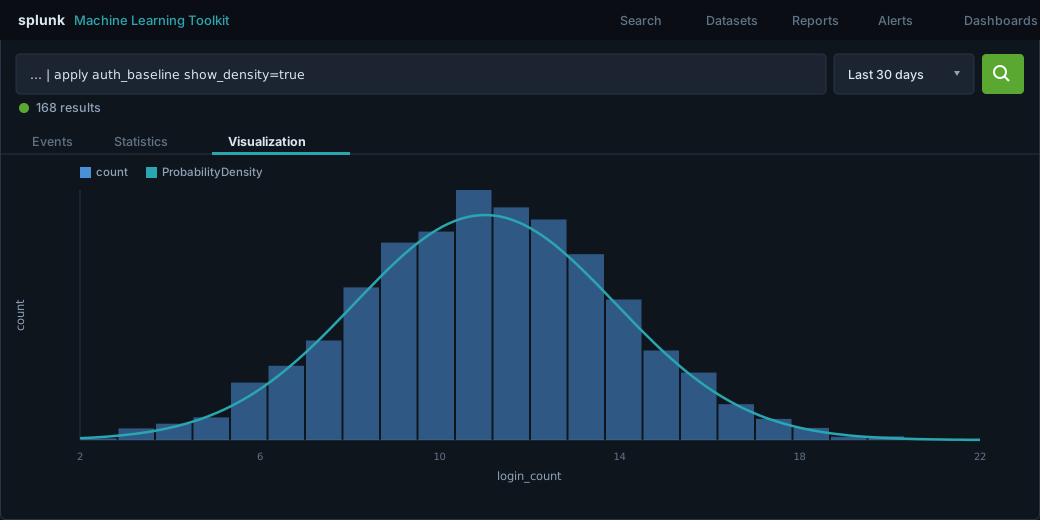 Görselleştirme sekmesinde bir kullanıcı için öğrenilen yoğunluk; kuyruğa düşen değerler aykırı kabul edilir.
Parametreler, anomali tespitinde doğrudan sonucu belirleyen ayarlardır:
by user— asıl belirleyici seçim budur. Her kullanıcı için ayrı bir dağılım fit edilir; bir yönetici hesabının “normal”i ile bir son kullanıcının “normal”i aynı olmak zorunda değildir. En fazla 5 alanla gruplama yapılabilir; varsayılan 1024 grup sınırımax_groupsile artırılabilir.dist=auto— MLTK dört dağılımı (norm,expon,gaussian_kde,beta) dener ve en iyi uyanı seçer. Verinin dağılımı bilinmiyorsaautogüvenli bir başlangıçtır. Sayım verileri genellikle sağa çarpık olduğundan, bilinçli bir tercihledist=exponçoğu zaman hem hızlı hem kararlı sonuç verir.threshold=0.01— dağılımın hangi oranının aykırı sayılacağını belirler (varsayılan %1). Olasılık yoğunluğu en düşük %1’lik bölgeye düşen her noktaIsOutlier=1değerini alır. Bu değer, doğrudan false positive oranını etkiler.show_density=true— çıktıyaProbabilityDensityalanını ekler. Yalnızca 0/1 bayrağı değil, “ne ölçüde beklenmedik” bilgisi de gerekiyorsa (RBA puanı için gereklidir) bu seçenek açılmalıdır.
3. Modeli incelemek: summary
Model eğitildikten sonra doğrudan canlıya alınmamalı, önce içeriği incelenmelidir:
| summary app:auth_baseline
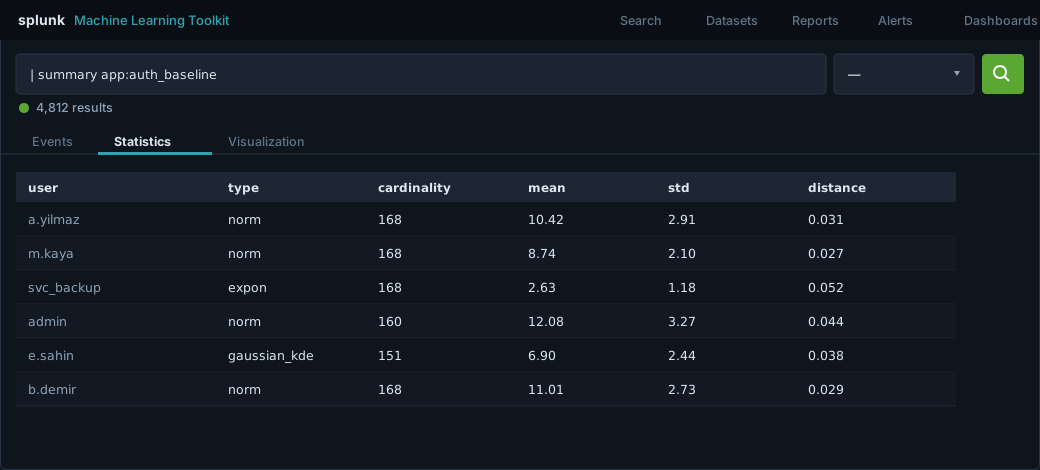 İstatistik sekmesinde
summary çıktısı; her kullanıcı için seçilen dağılım tipi ve uyum mesafesi.
Çıktıda her grup (kullanıcı) için seçilen dağılım tipi (type), ortalama ve standart sapma, kardinalite ve wasserstein / kolmogorov_smirnov mesafesi yer alır. Mesafe metriği, öğrenilen dağılımın gerçek veriye ne kadar uyduğunu gösterir; değerin yüksek olması o grup için modelin zayıf olduğuna işaret eder ve ilgili kullanıcının ayrı değerlendirilmesini gerektirebilir. Deterministik davranan servis hesaplarının dağılımı dar ve sivri çıkar; bu beklenen bir sonuçtur ve en küçük sapmaların yakalanmasını sağlar.
4. Canlıya almak: apply
Model hazır olduğunda taze veriye uygulanır. Son bir saati skorlayıp yalnızca aykırı değerleri süzüyoruz:
index=auth action=success earliest=-1h@h latest=now
| bin _time span=1h
| stats count AS login_count by _time, user
| apply auth_baseline
| where 'IsOutlier(login_count)'=1
| sort - 'ProbabilityDensity(login_count)'
| table _time, user, login_count, "IsOutlier(login_count)", "ProbabilityDensity(login_count)"
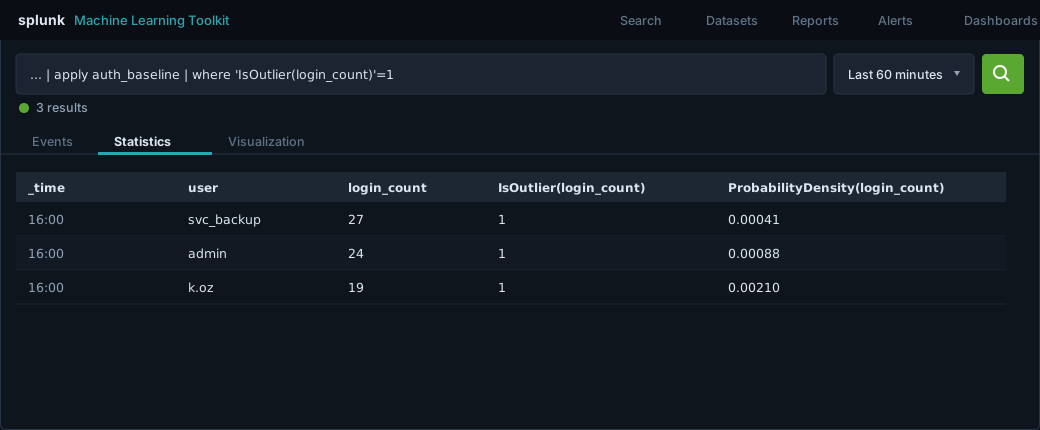 İstatistik sekmesinde
apply çıktısı; ProbabilityDensity ne kadar küçükse değer o kadar beklenmediktir.
Alan adlarındaki tek tırnaklara dikkat edilmelidir: IsOutlier(login_count) parantez içerdiğinden SPL’de tek tırnakla sarılması gerekir, aksi halde ayrıştırıcı hata verir. Yukarıdaki çıktıda svc_backup hesabı normalde 2–3 bandındayken 27 değerine çıkmış ve ProbabilityDensity değeri belirgin biçimde düşmüştür.
Aynı sonuç zaman ekseninde görselleştirildiğinde durum daha net izlenir — mavi çizgi gerçek trafiği, kırmızı noktalar modelin aykırı olarak işaretlediği saatleri gösterir:
index=auth action=success earliest=-3d@d latest=now
| bin _time span=1h
| stats count AS login_count by _time, user
| apply auth_baseline
| timechart span=1h sum(login_count) AS login_count, sum('IsOutlier(login_count)') AS anomalies
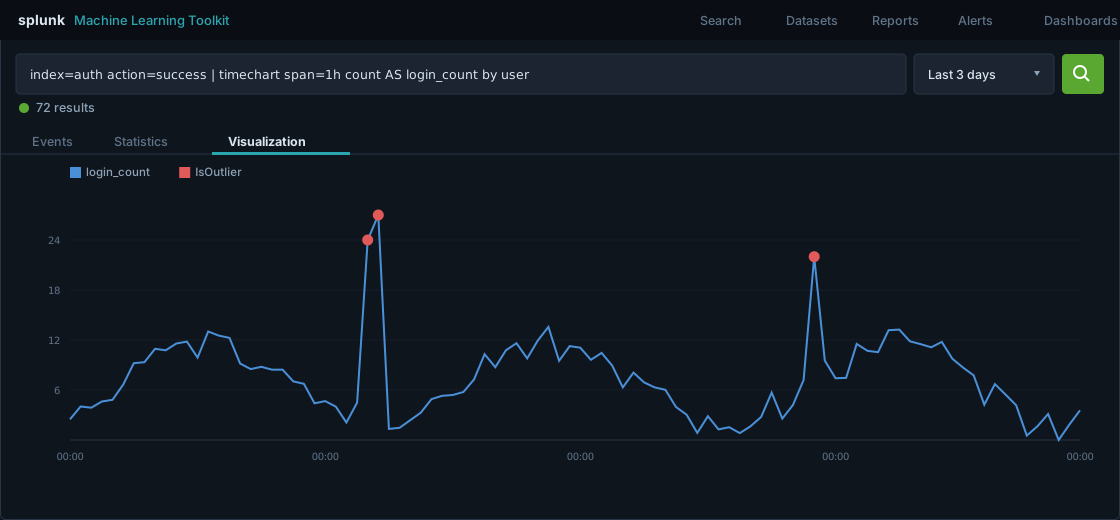 Görselleştirme sekmesinde beklenen aralığın (gölgeli bant) dışına taşan saatler anomali olarak işaretlenmiştir.
5. Eşiği ve dağılımı ayarlamak
İlk modelin yüksek oranda false positive üretmesi olağandır. Ayar üç noktadan yapılır.
Eşik. threshold değerini düşürmek (örneğin 0.005) daha az sayıda, ancak daha yüksek güvenilirlikte alarm üretir. Oturum açma senaryosunda yalnızca yüksek taraf anlamlı olduğundan — düşük sayım alarm oluşturmaz — tek yönlü eşik kullanmak daha isabetlidir:
... | fit DensityFunction login_count by user into app:auth_baseline
    dist=auto upper_threshold=0.01 show_density=true
Katmanlı eşik. Birden fazla eşikle iki seviyeli uyarı tanımlanabilir; biri “izle”, diğeri “müdahale et”:
... | apply auth_baseline threshold="0.01,0.001"
Bu kullanım IsOutlier(login_count)_th=0.01 ve ..._th=0.001 biçiminde ayrı kolonlar döndürür; düşük eşikli sonuç doğrudan notable olaya, yüksek eşikli sonuç ise risk puanına bağlanabilir.
Dağılım. dist=auto bazı durumlarda beklenenden farklı bir dağılım seçerek sınırları bozabilir. Sayım verilerinde dist=expon veya exclude_dist="beta" genellikle daha kararlı sonuç verir. Kararsız kalınan durumda, aynı veriyle iki model eğitip summary çıktısındaki mesafe metrikleri karşılaştırılabilir.
6. Yeniden eğitim ve concept drift
Model, eğitildiği andaki durumu temsil eder; ortam ise değişir. Yeni bir projeyle bir ekibin trafiği kalıcı olarak artarsa, eski baz çizgi sürekli yanlış alarm üretmeye başlar. İki yöntem uygulanabilir.
Tam yeniden eğitim, zamanlanmış bir aramaya bağlanarak (örneğin her gece) modeli düzenli biçimde tazeler. Büyük veri hacminde tüm geçmişi yeniden işlemek maliyetliyse, incremental fit (partial_fit) ile model yalnızca yeni veriyle güncellenir:
index=auth action=success earliest=-1d@d latest=@d
| bin _time span=1h
| stats count AS login_count by _time, user
| fit DensityFunction login_count by user into app:auth_baseline partial_fit=true
partial_fit=truekullanıldığında yeni parametreler (yenithreshold,distvb.) yok sayılır; model mevcut ayarlarıyla devam eder. Dağılımın değiştirilmesi gerekiyorsa tam yeniden eğitim yapılmalıdır.
Ek olarak cold start durumu göz önünde bulundurulmalıdır: yeni eklenen bir kullanıcının modeli henüz yoktur. Bu kayıtların apply sonrası isnull() ile ayrılıp ayrı bir “yeni varlık” kuralına yönlendirilmesi, eksik modele dayalı karar vermekten daha güvenlidir.
7. Tespiti operasyonel hale getirmek
Yalnızca bir panoda görüntülenen sorgu, operasyonel bir tespit değildir. İki yöntem öne çıkar.
Zamanlanmış alarm. Yukarıdaki apply sorgusu saatlik çalışan bir scheduled search olarak tanımlanıp sonuç döndüğünde tetiklenebilir. Ancak tek başına üretilen alarmlar çoğu zaman gürültüye yol açar.
Risk tabanlı tespit (RBA). Anomaliyi doğrudan notable olaya çevirmek yerine kullanıcının risk puanına katkı olarak yazmak daha etkili bir yaklaşımdır. ProbabilityDensity değeri düştükçe katkı artar:
index=auth action=success earliest=-1h@h latest=now
| bin _time span=1h
| stats count AS login_count by _time, user
| apply auth_baseline
| where 'IsOutlier(login_count)'=1
| eval density='ProbabilityDensity(login_count)'
| eval risk_score = round(min(100, 30 + 12 * ln(1 / (density + 0.0001))), 0)
| eval risk_object=user, risk_object_type="user",
       risk_message="Oturum açma hacminde anomali: ".login_count." (baz çizgi dışı)"
| table _time, risk_object, risk_object_type, risk_score, risk_message
| collect index=risk
Böylece tek bir anomali tek başına alarm üretmez; aynı kullanıcıda aynı gün içinde biriken sinyaller — anomali, farklı kaynaktan oturum, yeni bir süreç — risk eşiğini aştığında tek ve bağlam açısından zengin bir notable olaya dönüşür. Splunk Enterprise Security kullanılıyorsa bu akış doğrudan bir Risk Incident Rule’a bağlanır. Makine öğrenmesi tabanlı tespitin UEBA ile buluştuğu nokta budur.
Tek değişkenin ötesi
Tek bir alan her zaman yeterli olmaz; “az oturum fakat yüksek veri çıkışı” gibi kombinasyonlar tek değişkenle yakalanamaz. Çok değişkenli tespitte MLTK’nin hazır bir sarmalayıcısı vardır: MultivariateOutlierDetection, arka planda StandardScaler → PCA → DensityFunction zincirini kurar:
index=auth earliest=-30d@d latest=@d
| bin _time span=1h
| stats count AS login_count, dc(src_ip) AS distinct_src, sum(bytes_out) AS bytes_out by _time, user
| fit MultivariateOutlierDetection login_count distinct_src bytes_out by user into app:auth_mv threshold=0.005
Alternatiflere kısaca değinmek gerekirse: IsolationForest ve OneClassSVM, model into ile kaydedilip apply edilebildiğinden canlı skorlamaya uygundur; LocalOutlierFactor ise kaydedilemediği için daha çok keşif ve tek seferlik analiz amacıyla kullanılır. Kendi PyTorch/TensorFlow modeli, GPU veya container ihtiyacı doğduğunda süreç DSDL‘e (Splunk App for Data Science and Deep Learning, eski adıyla DLTK) taşınır. Çoğu SOC anomali ihtiyacı DensityFunction ile karşılanabildiğinden, daha ağır çözümlere ancak gerçek bir gereklilik doğduğunda geçilmesi önerilir.
Üretimde dikkat edilecek noktalar
Tasarım aşamasında sade görünen süreç, üretimde birkaç ayrıntıya bağlıdır:
- Model boyutu bir sınırdır. Binlerce kullanıcı
byile modellendiğinde lookup büyür vemlspl.confiçindekimax_model_size_mb,max_inputs,max_fit_timelimitlerine takılabilirsiniz. Bu durumda dönen hata her zaman açıklayıcı olmaz. Büyük ortamlarda kullanıcıları segmentlere (örneğin departman) bölüp ayrı modeller tutmak hem performans hem isabet açısından daha uygundur. - Kardinalite maliyeti artırır.
byalanındaki benzersiz değer sayısı doğrudan eğitim süresini belirler; yüksek kardinaliteli alanlarla (örneğin hamsrc_ip) gruplama yapmaktan kaçınılmalıdır. _timehizalaması önemlidir.bin span=1hileearliest/latestdeğerleri aynı sınıra oturtulmalıdır (@h,@d); aksi halde yarım kovalar yapay anomaliler üretir. Bu, sık karşılaşılan bir hatadır.- Lookup izinleri.
fitile kaydedilen model bir lookup olduğundan,app:kapsamında kaydedilip paylaşım izinleri ayarlanmazsa zamanlanmış arama “model bulunamadı” hatası döndürür.into app:...ile kapsam bilinçli seçilmelidir. - PSC sürümü. MLTK yükseltildiğinde PSC eklentisinin de uyumlu sürüme güncellenmesi gerekir; sürüm uyumsuzluğu
fitkomutunu sessizce bozabilir.
Statik eşikten baz çizgi öğrenen bir modele geçmek, kural sayısını azaltmaz; ancak tespiti “bütün popülasyona tek değer” yaklaşımından “her varlığa kendi normali” yaklaşımına taşır. Modeli bir süre canlıda gözlemleyip ürettiği aykırı değerleri doğrulamak, eşik ve dağılım seçimini verinin kendisine göre ayarlamanın en sağlıklı yoludur.
Kaynaklar
- Algorithms in the Splunk Machine Learning Toolkit — DensityFunction ve diğer algoritmaların resmi referansı
- Splunk Machine Learning Toolkit User Guide —
fit/apply/summarykomut sözdizimi